
主题
Claude Code Token 优化
从模型选择、上下文管理,到 LSP、计划模式、规则分层与数据预处理,汇总一批可直接落地的 Token 降本手段。文中的花费数据来自原笔记的实际账单对比。
目录
一、模型选择
不同模型回答同一个问题,消耗的 Token 量会有几倍的差别。
使用 /model 切换模型:简单任务用 Haiku,日常用 Sonnet,复杂推理用 Opus。
二、上下文管理
1. 定期 /compact
对于长对话,定期使用 /compact 压缩。
先用 /context 查看压缩之前的上下文:总共 200K 的上下文占用了 88%;

用 /compact 压缩后大小为 55.7K,占用 28%。
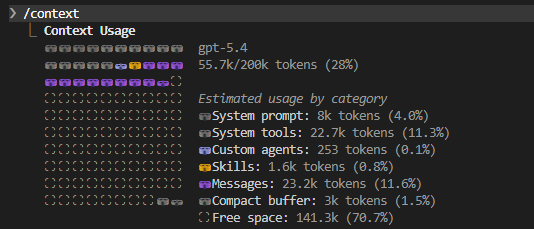
如果一直不清理,上下文占满后会报错:Context limit reached · /compact or /clear to continue。

2. 阶段性 /clear
对于新任务,先使用 /clear 清理上下文。
三、恢复对话
如果 Claude Code 意外关闭又想继续会话,可以用 claude --continue 重连会话,跳过初始化开销;也可以用 claude --resume 重连某一个历史会话。
bash
# 继续上一次会话
claude --continue

# 选择一个历史会话恢复
claude --resume
四、临时提问
/btw 是 By The Way 的缩写,作用是让你「顺便问一句」,提问但不消耗上下文 Token。
五、只加载需要的文件
使用 @ 提及,引用单个文件或目录,限制 Claude Code 的搜索范围:
text
# 引用单个文件
@src/auth.ts

# 引用整个目录
@src/components/

# 引用多个文件
@src/auth.ts @src/user.ts @src/database.ts
六、启用 LSP
LSP(Language Server Protocol)是语言服务器协议,相当于 AI 的「高级导航」,配置之后能省下大约 40%(官方数据)的 Token 消耗。
1. 为什么能节省 Token
| 对比维度 | 配置 LSP 之前(模糊搜索) | 配置 LSP 之后(精准定位) |
|---|---|---|
| 工作方式 | 纯文本字符串匹配(grep) | 语法树分析,理解代码含义 |
| 典型操作 | 搜索函数名,返回所有匹配行 | 直接「跳转到定义」,一步到位 |
| 上下文理解 | 不理解作用域,可能混淆同名变量 | 完全理解作用域,识别真正的函数调用关系 |
| 准确性 | 低,噪音多,需要 AI 二次筛选 | 高,结果精准,无需额外判断 |
| 消耗的 Token | 极高,需要处理大量无关结果 | 较低,只处理精确的、有意义的信息 |
2. 示例:TypeScript 项目
安装语言服务器与对应的 Claude Code 插件。在终端中运行:
bash
npm install -g typescript-language-server typescripttypescript-language-server:负责理解代码语法、提供类型信息、查找引用等,是一个独立的引擎。
在 Claude Code 中运行:
text
/plugin install typescript-lsptypescript-lsp:告诉 Claude Code 如何启动并连接 typescript-language-server。
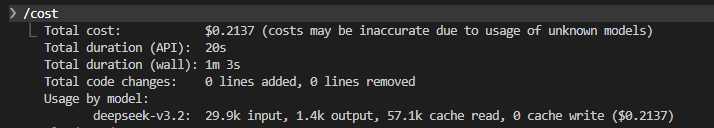
效果对比:安装 LSP 之前,查询一个函数大约花费 0.4319 美元;
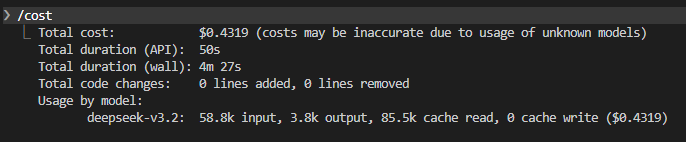
安装之后查询同一个函数大约花费 0.2137 美元,input 的 Token 量从 58.8K 降到 29.9K。
七、启用计划模式
对于小需求,使用 /plan 开启计划模式;对于中大型需求,使用 Superpowers 插件。核心都是先规划后执行,减少试错。
- Plan 模式:Claude Code 会安全地探索代码库、构思解决方案并制定详细的实施计划,不会触碰或修改任何文件。
- Superpowers:核心理念是通过一套标准化的工作流程,引导 AI 在动手写代码之前先做需求澄清、方案设计和测试用例编写,从而减少因规划不足导致的返工和混乱。
Superpowers 由三个核心技能组成:
| 技能、命令 | 阶段目标 | 工作流中的角色与行为 |
|---|---|---|
| brainstorming | 需求分析与设计 | 强制 Claude 先进行多轮对话,通过提问彻底理解需求,评估不同方案的优劣并对齐认知,最终把讨论结果整理保存到 docs/plans/ 目录下 |
| writing-plan | 制定开发计划 | 需求确认后,基于设计方案把复杂的开发任务拆解为一系列独立、细粒度(如 2-5 分钟可完成)的实施步骤,并为每步设定清晰的验证标准 |
| execute-plan | 执行计划(含 TDD) | 开始逐项执行计划,采用 TDD 模式:RED 先写一个必然失败的测试;GREEN 编写刚好能让测试通过的代码;REFACTOR 在测试保护下优化代码。完成一项后会等你确认再进入下一步 |
八、管理规则
1. 全局规则 CLAUDE.md
使用 /init 命令能够快捷创建 CLAUDE.md。
CLAUDE.md 是 Claude Code 的「项目记忆文件」,记录项目结构、构建命令、代码规范、架构决策等信息,让 Claude Code 快速理解项目上下文。可以把项目通用规则放在里面,以提供持久上下文。
但 CLAUDE.md 内容过长反而会消耗大量 Token,控制在 200 行以内是性能与成本的最佳平衡点。
2. 路径规则(.claude/rules/)
对于单体大仓库,全局的 CLAUDE.md(控制在 200 行以内)往往不够用,因此还需要借助作用域规则:只有当访问特定目录下的文件时,才会加载对应的规则。
项目目录结构:
text
your-project/
├── .claude/
│   └── rules/
│       ├── code-style.md   # 编码风格规则(通用)
│       ├── testing.md      # 测试规则(通用)
│       └── api-rules.md    # API 开发规范(仅作用于特定路径)
例如只希望 AI 在处理 src/service/** 目录下的文件时遵循 API 开发规范,可以创建 .claude/rules/api-rules.md:
markdown
---
paths:
  - "src/service/**/*.ts"
name: API 开发规范
description: 项目 API 层的编码与安全标准
---

# API 开发规则

1. **必须** 使用 TypeScript 严格模式(`"strict": true`)。
2. **必须** 为所有 API 添加中文注释。
保存文件后重启 Claude Code,提问「你知道我们项目的 API 开发规范吗?」;
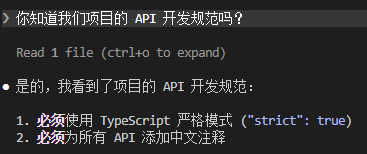
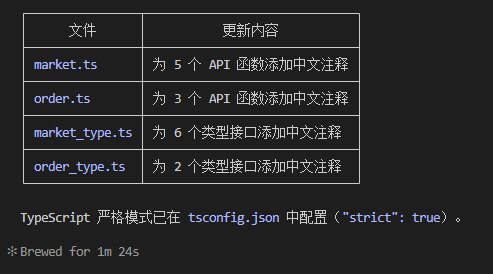
再让它按规则修改:「按照 api 规则帮我重构对应文件」。AI 会将 service 文件夹下的函数或类型接口等都加上中文注释。
九、数据预处理
利用 PreToolUse 钩子(类似于请求拦截器),在 Claude 执行操作前对输入的数据进行处理、压缩,从而减小 Token 使用量。
示例:rtk。rtk 会拦截并重写 Bash 命令的输出,比如 git diff 只展示文件差异的核心摘要。
1. 安装 rtk
- 访问 https://github.com/rtk-ai/rtk/releases。
- 在页面中找到类似
rtk-x86_64-pc-windows-msvc.zip的文件,下载到本地。 - 将压缩包解压到一个便于管理的专属文件夹,例如
D:\Develop\rtk。 - 在用户变量和系统变量列表中找到
Path,选中后点击编辑,新增D:\Develop\rtk。 - 重启 PowerShell 或 CMD 终端,运行:
bash
rtk --version出现版本号说明安装成功。
2. 配置到 Claude Code
在 PowerShell 或 CMD 终端中运行(需先退出 Claude Code):
bash
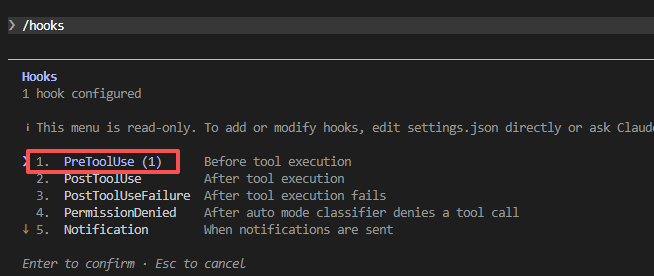
rtk init --global安装成功后,在 Claude Code 中运行 /hooks,可以看到 rtk 已安装在 PreToolUse 中。
3. 效果对比
本地修改了一些文件后运行:
bash
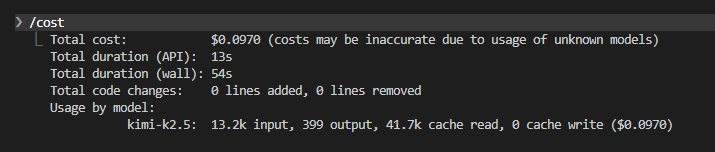
git diff | claude -p "解释这些更改"安装 rtk 之前的 Token 消耗大约 0.0970 美元;
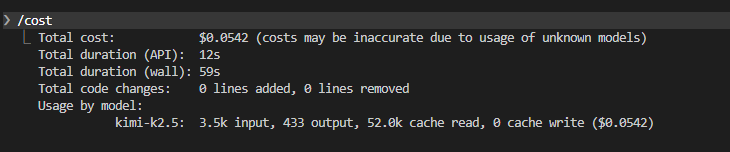
安装之后大约 0.0542 美元,input 的 Token 量从 13.2K 降到了 3.5K。
提示:除了使用
git命令,用cat/read去读文件内容时,也能大幅减小 input 的输入量。
十、自动化内存管理
Claude Code 默认自动开启 Auto Memory 功能,该功能会自动保存跨会话的学习心得,如构建命令、调试经验等。
这个「笔记本」在每个项目中都有独立的文件夹,路径为 ~/.claude/projects/<项目名>/memory/。
需要定期清理已过时或不再准确的偏好设置,否则每次会话都会加载。
十一、生成 .claudeignore
配置之后,大模型在上下文分析和代码搜索时不会自动包含被排除的目录。
可以让 AI 直接生成一份配置文件,例如输入:
text
创建一个 .claudeignore 文件,帮我排除掉不必要的目录,比如 node_modules